KMP&CMP 鸿蒙首版本正式发布
经过CPF-KMP-CMP SIG 社区伙伴们的共建,面向鸿蒙的 KMP&CMP 首个 Release 版本如约与大家见面!
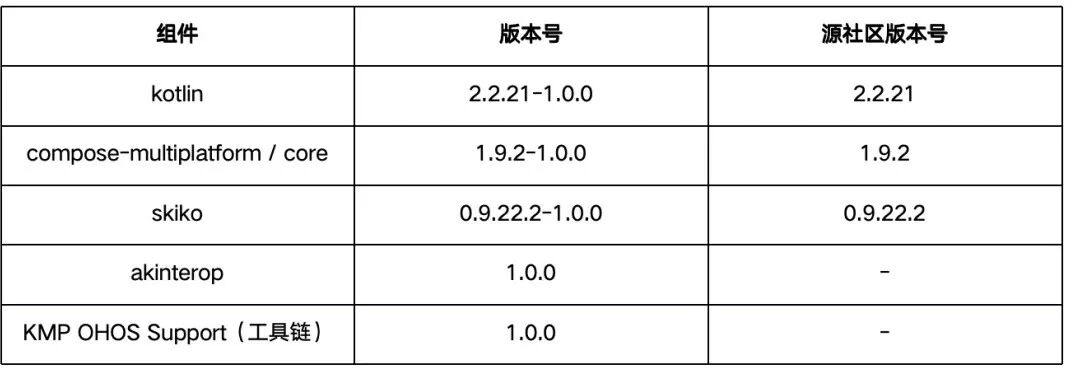
首版本基于源社区 KMP 2.2.21 / CMP 1.9.2,将 KMP 共享逻辑能力与 Compose UI 开发体验带入鸿蒙平台,并在编译构建、运行时性能与内存、开发体验方向继续优化,为鸿蒙开发者带来逻辑跨端共享、UI 原生渲染的开发新范式。
对已经使用 KMP/CMP 做跨端业务的团队,该版本有助于降低迁到鸿蒙的改造成本。鸿蒙开发团队也可借助这套能力,做 Kotlin 与 ArkTS 混合开发,拓展技术选型。
一、从开箱到日常构建
1. 开箱上手
组件已发布至 Maven 仓;工具链插件 KMP OHOS Support 在 Android Studio 插件市场搜索安装。
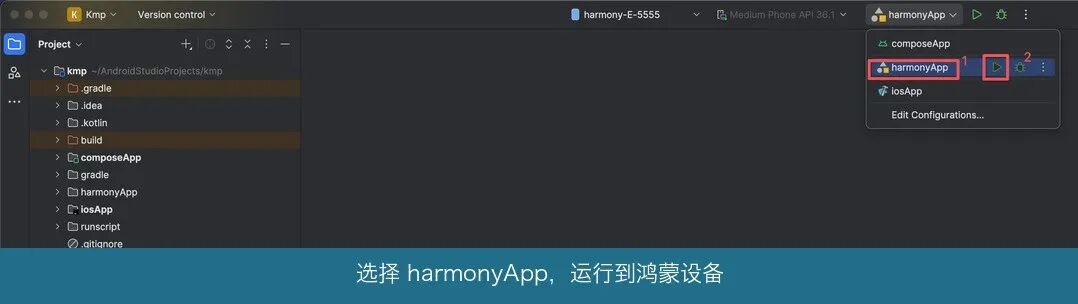
跑到设备分三步:
(1) DevEco Studio:用 6.0.0+ 下载 HarmonyOS SDK API 17+,打开工程里的 harmonyApp 配好调试签名。
(2) Android Studio:日常写 KMP&CMP 代码。
(3) Android Studio:选设备和 harmonyApp 点 Run(推包时保持 DevEco 运行)。
2. 日常构建更省心项目能跑通只是第一步。大型工程里,编译耗时过长、模块不好拆、改一点就要全量重编,都是高频痛点。
CPF-KMP-CMP 在构建侧提供这些能力:
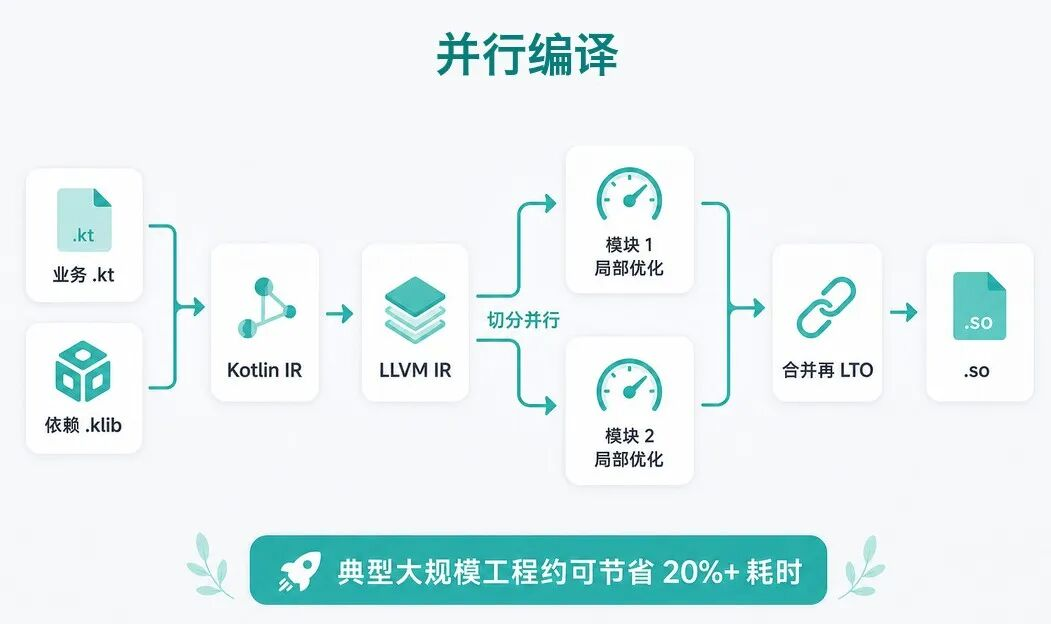
(1) 并行编译:将 LLVM IR 切分后多线程跑局部优化再合并,缩短大规模工程的编译等待;典型场景下约可节省 20%+ 耗时。
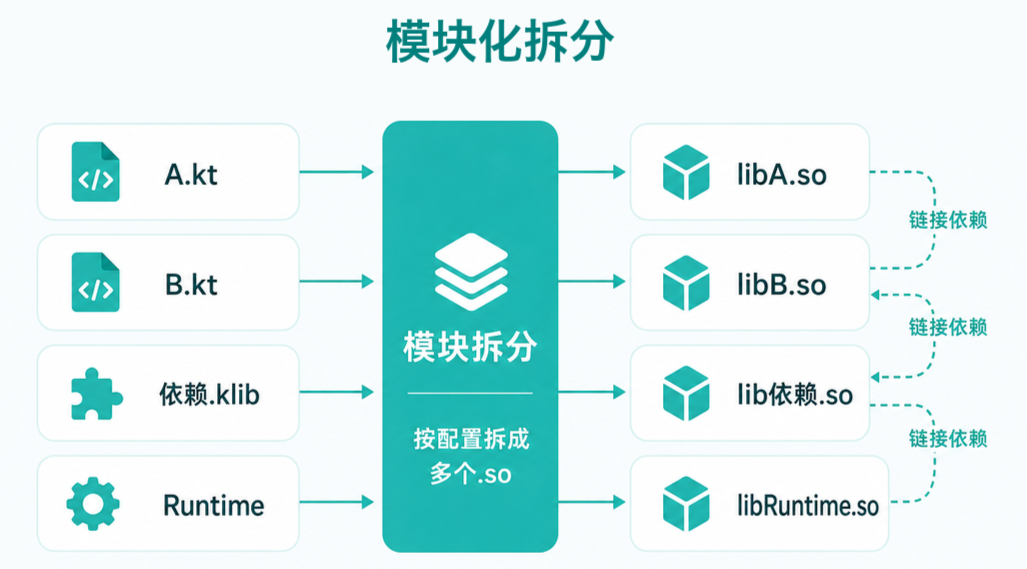
(2) 模块化拆分:单一 KMP 工程可配置成多个.so,配合分布式编译可进一步降低编译时间。
(3) Debug 增量编译:macOS / Linux 上支持基于静态库缓存的增量编译;只重新编译有改动的部分,其余复用缓存,不必每次全量重链。
二、开发体验:同一套开发模式上鸿蒙
1. Compose UI:沿用成熟 Compose 开发范式
已经在其他平台使用 CMP 的开发团队,界面业务代码可直接复用同一套 Compose 写法,不必为鸿蒙完全重新写一套 ArkUI。CPF-KMP-CMP 在鸿蒙侧提供了 compose.ui、compose.foundation、compose.material、compose.material3 的平台实现,可延续熟悉的声明式 UI 习惯开发鸿蒙端界面。
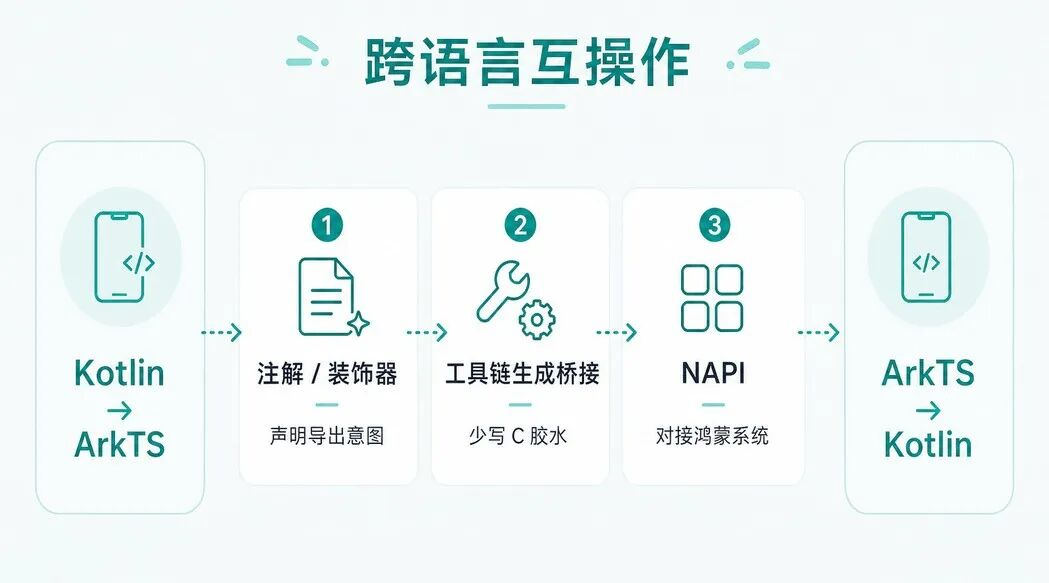
2. 跨语言:Kotlin ↔ ArkTS 互操作
很多存量鸿蒙项目已用 ArkTS 写系统能力或业务模块,很难整体迁成 Kotlin。共享逻辑可继续写 Kotlin,系统侧或存量模块仍用 ArkTS 时,用 akinterop 做双向互操作:注解 / 装饰器声明意图,工具链生成桥接,少写 C 胶水。基础类型、容器与异常可跨侧传递,存量工程可渐进接入,不必为互通推倒重来。
3. 多设备与无障碍:一套导航、跟随系统基于 Navigation3,实现一套导航模型覆盖多设备:直板机窄屏仍是单栏;折叠屏或平板上,列表与详情可按主从关系左右分栏。按推荐方式维护导航栈并完成配置即可,不必从零手写一套响应式双栏。
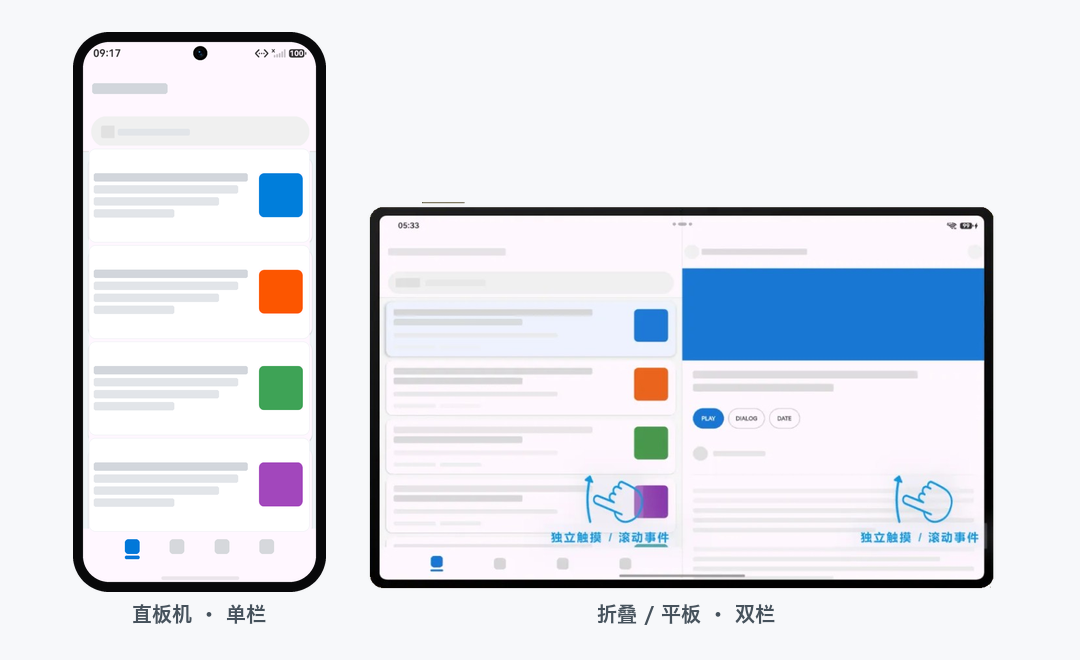
无障碍方面,Compose 语义树对接鸿蒙系统能力,屏幕朗读、触摸浏览,以及大字体、字体加粗与深色模式可开箱跟随系统;业务补充可读名称与角色后体验更完整,也少自建一套无障碍管线。
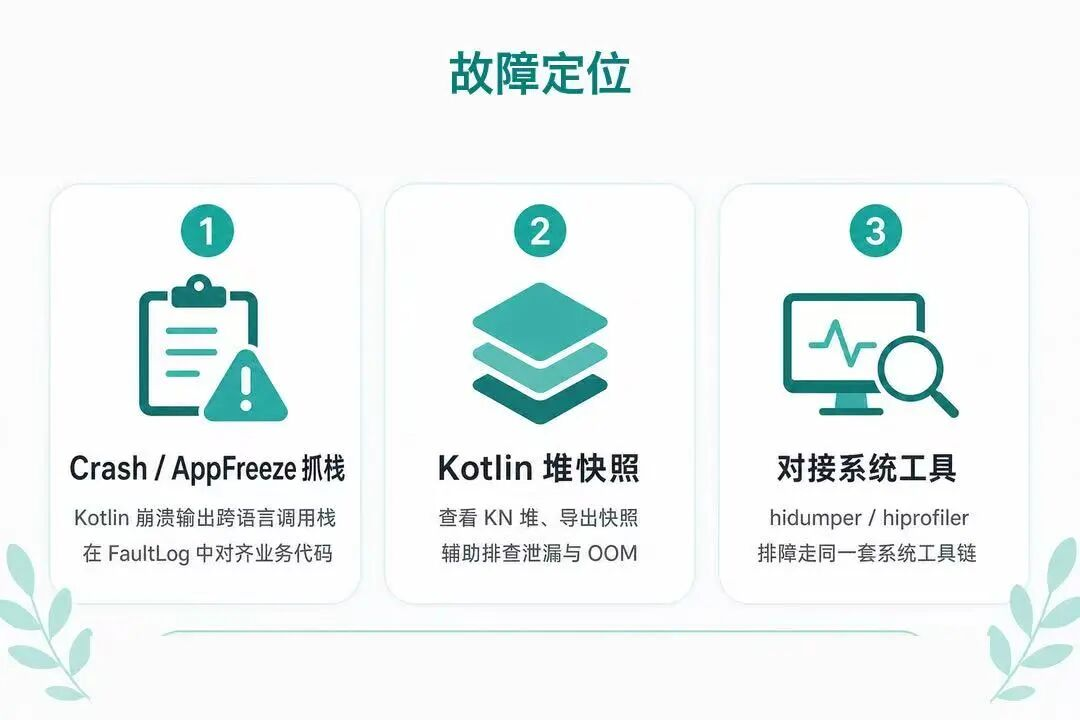
4. 故障定位:问题看得见、查得清跨平台业务上鸿蒙后,排障链路要同样走得通:
▪ Crash/AppFreeze:Kotlin 崩溃可输出含跨语言场景的调用栈,便于在 FaultLog 中对齐业务代码
▪ 内存问题:对接hidumper、hiprofiler等系统工具,查看Kotlin堆、导出堆快照,辅助排查泄漏与 OOM
三、应用体验:流畅、低内存、不空转
1. 流畅度优化:统一渲染
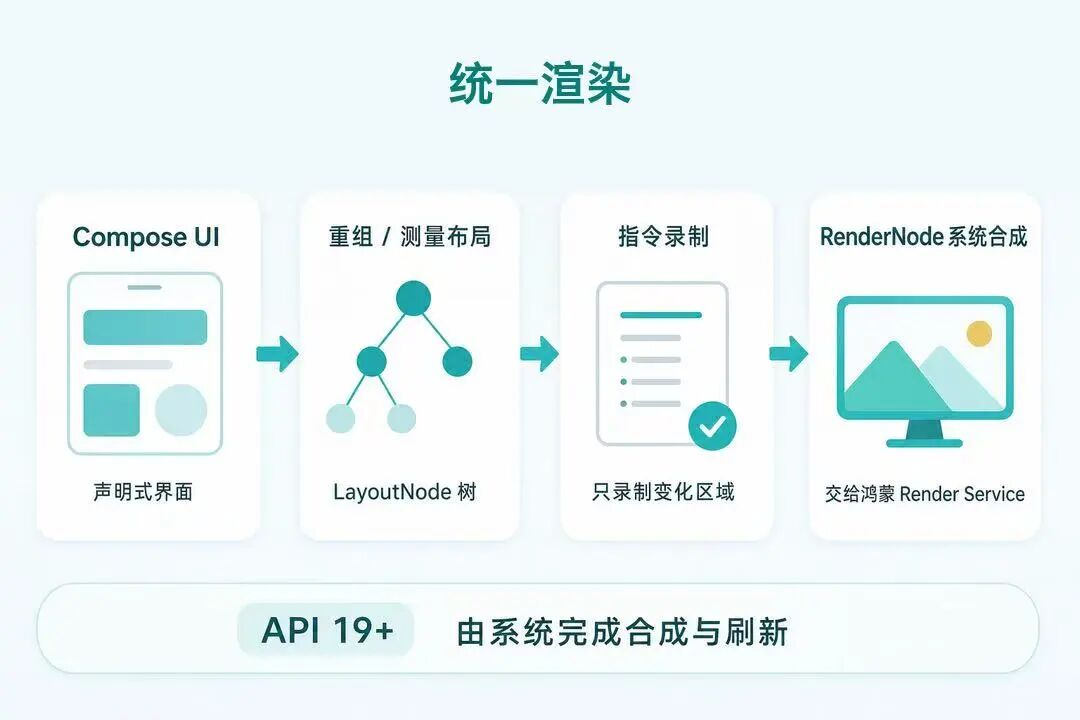
传统跨平台 UI 方案常自建渲染管线,这容易带来额外初始化与合成开销,也容易出现启动慢、动画和系统表现不一致等问题。CPF-KMP-CMP 将 Compose 绘制能力对接鸿蒙 Render Service / RenderNode 系统渲染能力,由鸿蒙系统统一完成合成与刷新调度(统一渲染需API 19及以上)。
业务可以获得多重收益:
▪ 更快首帧表现:减少自渲染初始化等待,启动、跳转和首屏更利落;
▪ 精细化局部刷新:状态变化才驱动更新,并支持局部录制,只重绘变化区域;
▪ 原生组件友好混排:Compose 页面可与 ArkUI、C-API 混排,地图、视频等原生能力更容易嵌进 Compose 页面 ;
▪ 对齐系统动画合成:帧节奏走系统 DisplaySync,体验与鸿蒙应用更一致。
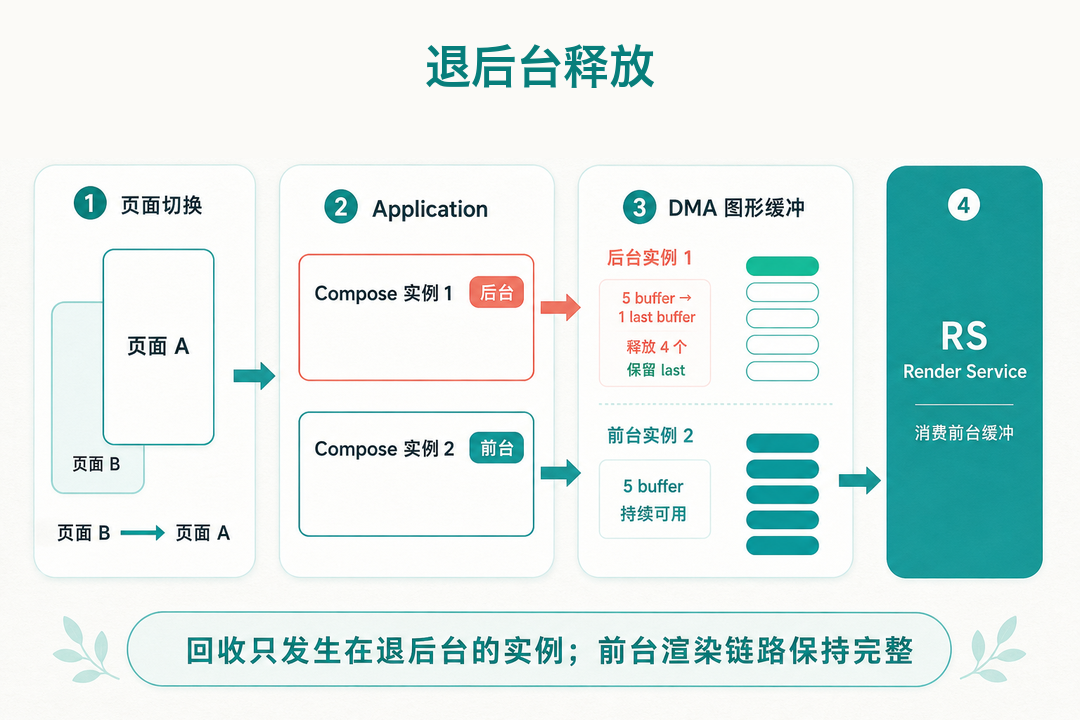
2. 内存占用优化:CommonGC+ 退后台释放图形缓冲
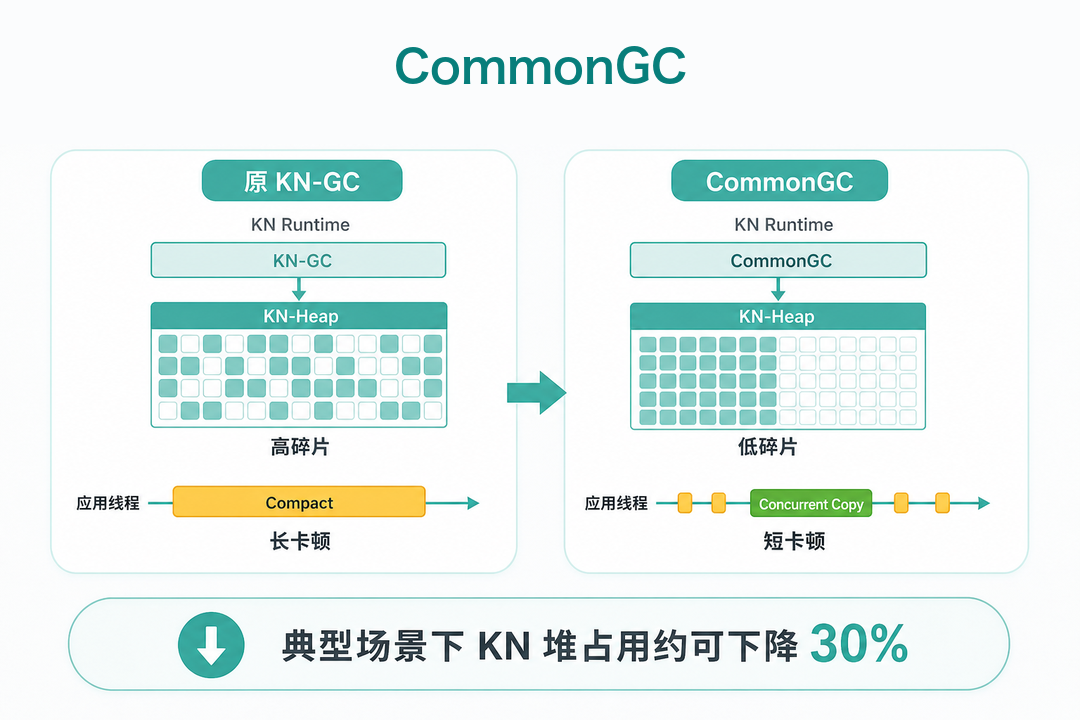
KMP 应用运行时内存开销主要来自 KN 堆(GC 管理)和 图形渲染缓冲。
CPF-KMP-CMP 在这两方面都做了优化:
(1) CommonGC 垃圾回收器:采用并发标记—复制回收算法,降低内存碎片、减少 GC 停顿时间,典型场景下 KN 堆占用约可下降 30%。
(2) 后台资源释放策略:当页面进入后台时,主动释放 DMA 多余图形缓冲资源,针对图片流、长列表这类高内存场景,显著降低应用后台驻留内存压力。
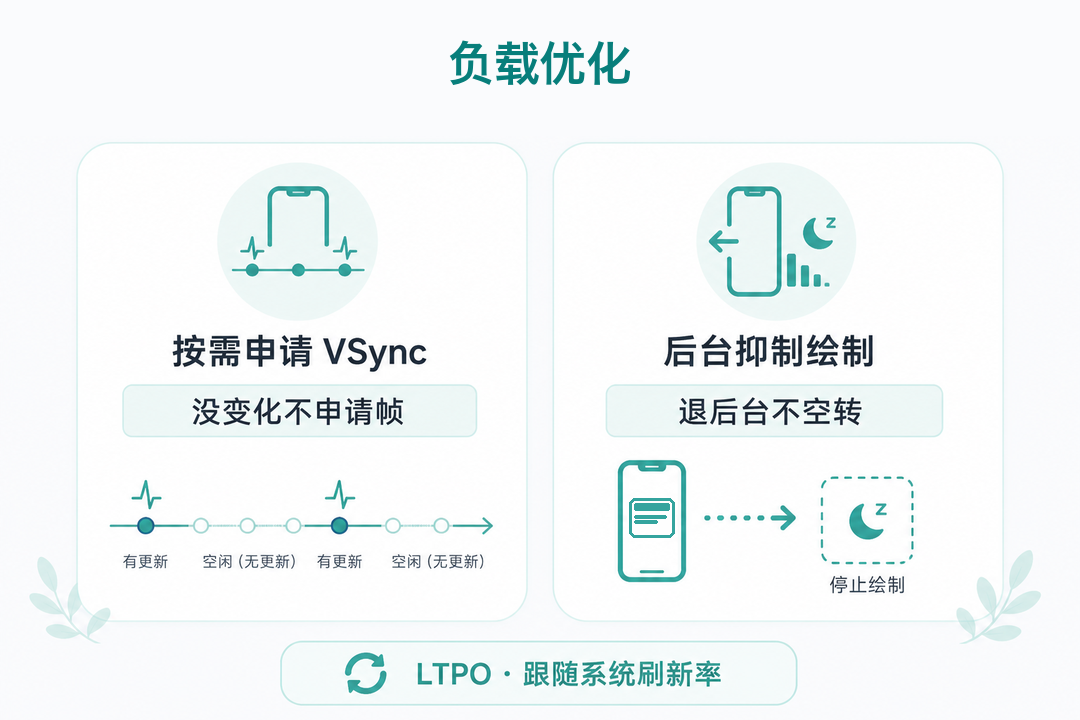
3. 负载优化:按需帧更新,后台不空转统一渲染路径支持按需申请 VSync 信号,当页面没有内容变化时,主动抑制刷新绘制;同时支持 LTPO 硬件特性,应用退到后台之后自动停止无效绘制循环,减少 CPU 占用与电量消耗,该行为为框架默认行为,不需要业务额外编写代码关闭动画、停止刷新。
即刻体验
CPF-KMP-CMP 鸿蒙平台首个正式版本已正式发布。欢迎上手验证、在社区提交 Issue/Discussion 反馈问题与需求,共同打磨 KMP&CMP 在鸿蒙平台上的生态与产品能力。
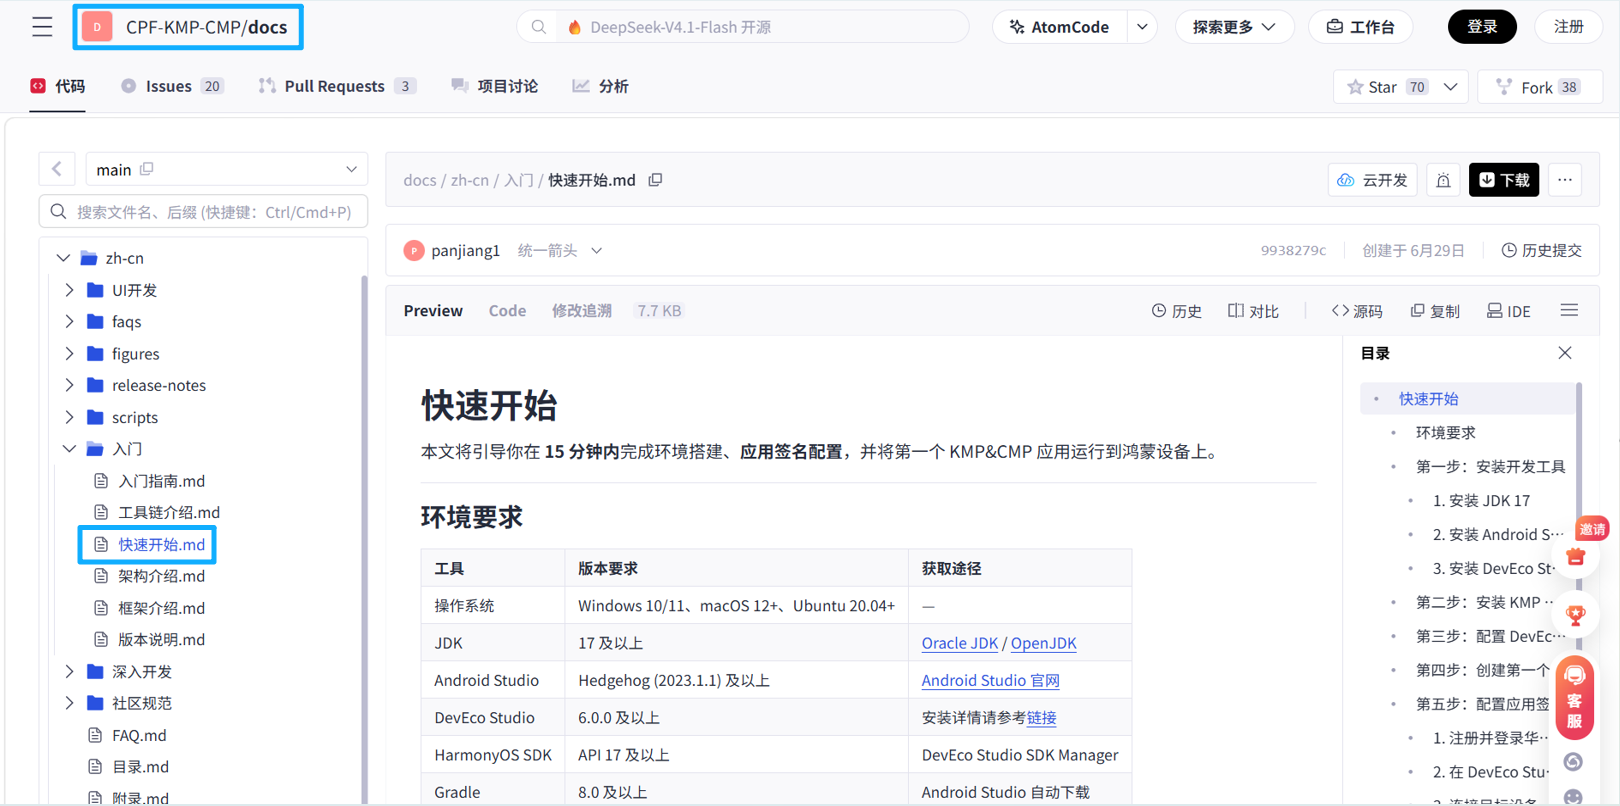
登录AtomGit ,搜索“CPF-KMP-CMP/docs”关键词即可获取相关文档集合:
参与社区共建
加入 CPF-KMP-CMP 社区,参与 KMP&CMP 鸿蒙版本规划和技术共建。
1.本网刊载内容,凡注明来源为“飞象网”和“飞象原创”皆属飞象网版权所有,未经允许禁止转载、摘编及镜像,违者必究。对于经过授权可以转载,请必须保持转载文章、图像、音视频的完整性,并完整标注作者信息和飞象网来源。
2.凡注明“来源:XXXX”的作品,均转载自其它媒体,在于传播更多行业信息,并不代表本网赞同其观点和对其真实性负责。
3.如因作品内容、版权和其它问题,请在相关作品刊发之日起30日内与本网联系,我们将第一时间予以处理。
本站联系电话为86-010-87765777,邮件后缀为cctime.com,冒充本站员工以任何其他联系方式,进行的“内容核实”、“商务联系”等行为,均不能代表本站。本站拥有对此声明的最终解释权。
直击2026中国算力大会,查看三大运营商的算力成绩单
随着人工智能等新一代信息技术快速发展,算力已成为推动科技创新、产业升级和社会进步的重要驱动力。根据最新发布的《2026综合算力全景分析》显示,我国综合算力基础持续夯实,正从“建得多..[详细]
一阖一辟谓之变!读懂中国联通“四大图谱”
人工智能大潮涌动,越来越多的行业开始从技术进步中受益,继而更加坚决、深入地引入人工智能技术和服务。作为全球领先的电信运营商,中国联通将如何应对这场全新的科技革命?[详细]
专题报道丨2026中国算力大会
9月11日至13日,2026中国算力大会在河北省廊坊市举行。大会以“共织算力网 智启新未来”为主题,紧扣全国一体化算力网新部署,汇聚政产学研用金等各方资源,搭建国家级产业交流、创新赋能、..[详细]
专题报道丨第27届中国国际光电博览会
9月的深圳国际会展中心,人比光密。9月9日,第27届中国国际光电博览会(CIOE)开幕首日,超4000家光电企业,吸引进场观众101741人,同比增加38%,热门展台前要"插空"才看得清展品。..[详细]
突破物理瓶颈,在深圳光博会寻找AI算力持续增长的答案
根据相关机构预估,包括AI工厂、词元经济在内,市场对于AI的需求已呈现出爆发式增长,基本上每两年就会有100倍以上的增长。然而,受限于半导体工艺和物理规律的硬性限制,单体 GPU 本身的能..[详细]
msup刘付强:别再比Token消耗量了,AI不是成本,是利润变量
当AI从技术工具演变为核心生产方式,企业如何跨越有模型、无利润的落地鸿沟?又怎样将零散的Agent应用,升维为可沉淀、可复制的组织级智能资产?在9月4日召开的第十一届A2M人工智能创新峰会..[详细]