长飞构建AI光互连全链生态:高速畅、换乘快、规划好
飞象原创(魏德龄/文)AI大模型正以惊人的速度迭代,在思维与推理能力上不断突破,参数量迈向万亿乃至十万亿规模。全球科技巨头持续加大对AI基础设施的投入,力争抢占人工智能技术高地。其背后是作为承载大模型训练与推理任务的智算中心在算力与运力上协同发力,从而形成更大更高效的算力集群规模,构建最强AI大脑。
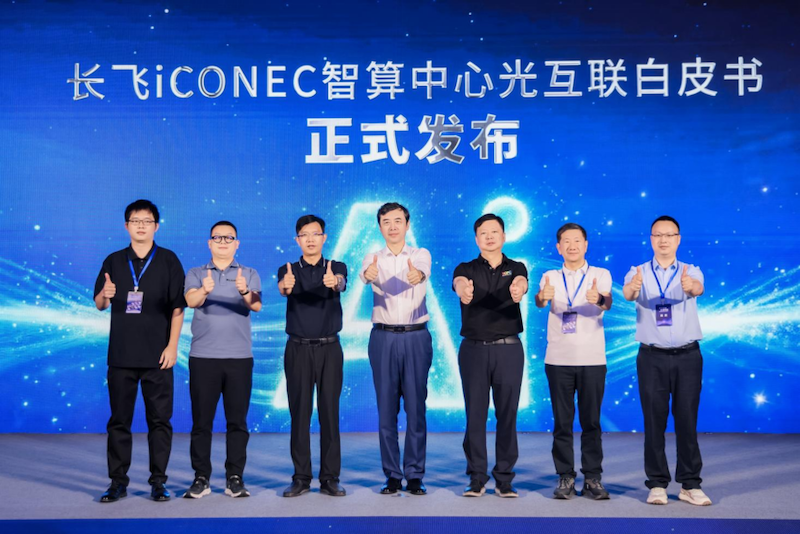
回顾2026深圳光博会期间,长飞iCONEC智算中心技术论坛上发布的《智算中心光互连白皮书》揭示了如今运力之于AI的重要作用,一场光互连技术变革正在展开,凭借其天然的高带宽、低损耗、抗电磁干扰及长距离传输优势,光互连正从传统的“传输管道”进化为支撑算力高效释放的“算力神经”。
从智算中心内部连接万卡级GPU,到跨中心组成算力集群,智算网络就像一套复杂的数据路网,任何一处“拥堵”或“断路”,都可能让局部感知失灵,甚至引发系统瘫痪。因此,“算力神经”需要完整的AI光互连全链生态:既要有“高速公路”,实现高算力密度、低时延、高带宽传输;也要有光电转换的“换乘枢纽”;更要有全局规划的布线系统,既支撑当下业务,也为未来算力扩容演进留出空间。
目前,长飞光互连生态下的多品类产品针对市场需求已实现了全链覆盖,让牵一发而动全身的“神经网络”能够全方面助推AI的快速演进需求。
AI推动智算中心网络架构演进
《智算中心光互连白皮书》中提及,光互连正在推动智算中心网络架构从三层架构向更扁平、更高效的方向演进,其网络架构涵盖前端网络、AI节点(Scale-Up),后端网络(Scale-Out)、智算中心互连(Scale-Across)。
Scale-Up是服务器/超节点内部专属总线,负责将节点内GPU整合为一体化算力资源共享池,其带宽需求为Scale-Out的10倍以上。Scale-Out的核心逻辑是扩容节点规模,依托高速光互连完成海量服务器组网,解决数万至数十万颗GPU协同调度难题,也是当前光模块需求的核心承载层级。
Scale-Across⾯向异地多座智算中⼼搭建⻣⼲链路,实现全域算⼒协同调度,⻓距传输刚需倒逼相⼲⾼速光模块规模化落地。以空芯光纤为代表的新型介质也正在Scale-Across中显现出巨大物理优势。
长飞“Scale Link”方案,从Scale-up、Scale-across、Scale-out三大维度出发,以空芯光纤、多芯光纤、G.654.E光纤、高端多模光纤、超大芯数ASR柔性带缆、全系列光器件等产品与解决方案为核心,构筑超大容量、超低时延、超低损耗的AI智算中心全光互联新底座,为AI算力释放提供坚实的光连接基石。
高速畅:新型光纤铺就AI超级公路
光互连技术在智算中心内部与多个智算中心之间的连接,犹如构建一个完整的经济区域路网,一方面实现城市内部的道路高速连接,另一方面也要通过超高速道路让城市间可以实现快速访问。
从应用情况不难发现,单模光纤正从传统的长途干线传输,深度渗透进智算中心的各个网络层级中。G.654.E光纤成为跨域互联的主力,大幅提高入纤光功率,抑制非线性效应,可将无中继传输距离延长30%以上,显著降低建网和运维成本;G.657.A2已经成为机柜内高密度互联及紧凑型光缆的首选;小外径弯曲不敏感单模光纤,破解传统光纤机柜物理承载极限。
多芯光纤实现了尺寸不变、容量倍增的空间重构,有效解决机柜空间承重、管道拥塞和散热阻碍的问题。目前,长飞多芯光纤已联合国内三大运营商完成城域网、智算互联及海洋传输等多场景应用,技术成熟度与可靠性得到充分印证,蓄力大规模商用部署,未来将成为支撑全球AI基础设施的关键基石。
空芯光纤是目前打破物理极限的革命性前沿介质,成为全球AI基础设施建设中的关注重点,微软已在24个月内部署了15000km HCF,国内三大运营商也已开通多条商用线。空芯光纤作为长飞的核心代表产品,凭借颠覆性的技术创新成为智算中心全光互联的“王牌”。近日,长飞空芯光纤衰减突破至0.032dB/km,刷新全球最低传输损耗纪录,全球领先实力再获印证。
换乘快:光模块构建高效转换枢纽
光模块可以看作是光电转换的枢纽,作为光互连链路中实现光电转换的核心节点,既是电信号的终点,也是光信号的起点,负责完成电信号与光信号的相互转换。
《智算中心光互连白皮书》介绍,目前800G可插拔光模块已实现规模化商用。而1.6T可插拔光模块行业标准已制定完成,头部厂商已完成样品迭代测试。但产业目前面临的核心技术挑战主要在于功耗、信号完整性、封口密度这三大壁垒。
基于铜互连方案的交换机因高能耗、低带宽密度的瓶颈,难以满足未来AI算力发展的需求。为彻底解决铜介质电互连的“带宽墙”与“功耗墙”瓶颈,业界正在推动光电合封技术(CPO)——通过将光引擎与交换、运算类ASIC芯片集成于同一基板,实现芯片级光互连,对突破能效瓶颈意义重大,是数据中心网络技术发展的重要方向。
长飞拥有材料、核心器件、解决方案协同布局的产业链。其中,核心光互联组件业务紧扣时代脉搏,在AI算力需求呈指数级增长、数据中心加速向高密度、低延迟演进的产业背景下,拥有从核心光模块到高密度配线、从有源光缆到全系列无源光器件的完整产品矩阵,全面展示其为AI数据中心及下一代通信网络构建“极致可靠、高效流转”互联底座的技术实力。
针对CPO方案带来的全新挑战,长飞推出多款创新FAU产品,覆盖激光器集成、现场重复插拔与高密度部署、硅波导与标准光纤低损耗耦合、多芯光纤扇入扇出等多种应用需求,以多样化的光纤阵列形态和可靠、可维护的设计,为CPO方案提供完整的光互连支撑。
规划好:综合布线立足当下放眼未来
布线方案犹如在物理层做好“神经网络规划”。综合布线品牌iCONEC作为长飞公司旗下唯一专业从事综合布线业务的子品牌,旗下智算布线解决方案已服务大量算力项目,积累丰富一线工程实践。
正是基于这些实践,iCONEC参编了《智算中心基础设施布线技术规程》。规程中提到,设计疏漏、施工粗糙的布线系统,极易成为制约算力释放的“瓶颈”,不仅引发性能衰减,更可能埋下运维故障的隐患;而具备前瞻性规划与高标准建设的布线系统,既是保障当前业务连续运转的坚实基础,更是支撑未来算力平滑扩容、技术灵活演进的核心骨架。
与此同时,《智算中心光互连白皮书》专门强调了当前智算中心系统布线的发展趋势——面向AI数据中心的高密度、多平面网络架构,正在成为主流。针对这一趋势,iCONEC推出了Shuffle Box——通过内部预定义的纤芯路由(如4X4、2X2等模块),将原本混乱的点对点连接转化为有序的、可集中管理的交叉连接,从而高效实现多平面拓扑与Rail优化,解决了GPU集群规模扩展带来的布线复杂性问题,同时增强了网络弹性与可靠性。
从高速畅的光纤,到换乘快的光模块,再到规划好的综合布线方案,正在加速向“全球AI光连接基础设施的领导者”跃迁的长飞,通过以覆盖材料、器件、模块到基础设施的全链布局,构筑AI变革最坚实底座,让算力与思维能够在以超大容量、超低时延、超低损耗的“三超”神经网络中点亮AI灵光。
1.本网刊载内容,凡注明来源为“飞象网”和“飞象原创”皆属飞象网版权所有,未经允许禁止转载、摘编及镜像,违者必究。对于经过授权可以转载,请必须保持转载文章、图像、音视频的完整性,并完整标注作者信息和飞象网来源。
2.凡注明“来源:XXXX”的作品,均转载自其它媒体,在于传播更多行业信息,并不代表本网赞同其观点和对其真实性负责。
3.如因作品内容、版权和其它问题,请在相关作品刊发之日起30日内与本网联系,我们将第一时间予以处理。
本站联系电话为86-010-87765777,邮件后缀为cctime.com,冒充本站员工以任何其他联系方式,进行的“内容核实”、“商务联系”等行为,均不能代表本站。本站拥有对此声明的最终解释权。
新易盛张金双:打破光瓶颈,迎接高速光模块下一个黄金周期
在第27届CIOE中国国际光电博览会期间举办的“光引未来•大咖说”高端对话上,成都新易盛通信技术股份有限公司商务副总张金双,解析了硅光、薄膜铌酸锂、LPO(线性可插拔)/LRO(线性接..[详细]
直击2026中国算力大会,查看三大运营商的算力成绩单
随着人工智能等新一代信息技术快速发展,算力已成为推动科技创新、产业升级和社会进步的重要驱动力。根据最新发布的《2026综合算力全景分析》显示,我国综合算力基础持续夯实,正从“建得多..[详细]
一阖一辟谓之变!读懂中国联通“四大图谱”
人工智能大潮涌动,越来越多的行业开始从技术进步中受益,继而更加坚决、深入地引入人工智能技术和服务。作为全球领先的电信运营商,中国联通将如何应对这场全新的科技革命?[详细]
专题报道丨2026中国算力大会
9月11日至13日,2026中国算力大会在河北省廊坊市举行。大会以“共织算力网 智启新未来”为主题,紧扣全国一体化算力网新部署,汇聚政产学研用金等各方资源,搭建国家级产业交流、创新赋能、..[详细]
专题报道丨第27届中国国际光电博览会
9月的深圳国际会展中心,人比光密。9月9日,第27届中国国际光电博览会(CIOE)开幕首日,超4000家光电企业,吸引进场观众101741人,同比增加38%,热门展台前要"插空"才看得清展品。..[详细]
突破物理瓶颈,在深圳光博会寻找AI算力持续增长的答案
根据相关机构预估,包括AI工厂、词元经济在内,市场对于AI的需求已呈现出爆发式增长,基本上每两年就会有100倍以上的增长。然而,受限于半导体工艺和物理规律的硬性限制,单体 GPU 本身的能..[详细]